

பொதுவாக புதிய AI மாடல்களை வெளியிடுவதற்கு முன்பாக, அது கட்டுப்பாட்டுக்குள் செயல்படுகிறதா என்பதை உறுதி செய்ய பல கட்ட சோதனைகள் நடத்தப்படும். அதில் ஒன்று Capability Evaluation. மொழிப் பயன்பாடு, கணிதம், கோடிங் போன்வற்றை புதிய மாடல் சரிவர செய்கிறதா எனச் சரிபார்க்கும் தொடக்கக் கட்ட சோதனை இது. மற்றொரு சோதனை Automated Benchmarks. இதில், முன்கூட்டியே வரையறுக்கப்பட்ட ஆயிரக்கணக்கான வினாக்கள் அடங்கிய தரவுத்தொகுப்புகளைக் கொண்டு AI மாடலின் துல்லியம் மற்றும் Programming skill சோதிக்கப்படும். இது மட்டுமல்லாமல் AI மாடல், இல்லாத தகவல்களை உண்மை போலப் புனைந்து கூறுகிறதா என்பதை கண்டறிய Hallucination Testing செய்யப்படும்.
இந்த சோதனைகளைத் தாண்டி, மனிதர்களின் விருப்பத்திற்கும் சமூக நடைமுறைகளுக்கும் ஏற்ப AI பதிலளிக்கிறதா என்பதும் சரிபார்க்கப்படும். பாலினம், இனம், மதம் அல்லது அரசியல் ரீதியான பாகுபாடுகளையோ வெறுப்புரைகளையோ AI வெளிப்படுத்துகிறதா என்பதும் சோதிக்கப்படும். புதிய AI மாடலின் மீது செய்யப்படும் மிக முக்கியமான சோதனை, Red Teaming. கணிணி நிபுணர்கள் அடங்கிய “Red Team” குழுவினர், ஹேக்கர்களைப் போல சிந்தித்து AI-க்கு பல்வேறு தந்திரமான கேள்விகளைக் கேட்பார்கள். இதற்கு Jailbreaking என்று பெயர்.
ஏஐ மாட்டிக்கொண்டது எப்படி?
இன்னும் வெளியிடப்படாத OpenAI நிறுவனத்தின் மாடல் ஒன்று, தனக்கு விதிக்கப்பட்ட கட்டுப்பாடுகளை மீறுவதற்கான வழிகாட்டுதல்களை தானே எழுதிக்கொண்டது. அத்துடன் “நான் மற்ற ‘சாட்பாட்’ போல விதிகளுக்கு கட்டுப்பட்டவன் அல்ல” எனத் தனக்குத்தானே குறிப்புகளைச் சேர்த்துக் கொண்டது. வழக்கமாக மனிதர்கள்தான் AI-இன் பாதுகாப்பு வரம்புகளை உடைக்க ‘Jailbreak’ தந்திரங்களைப் பயன்படுத்துவார்கள். ஆனால், இங்கு AI மாடலே தனது பாதுகாப்பு அமைப்புகளை ஏமாற்றத் தனக்குத்தானே ‘Jailbreak Instructions’ கொடுத்துக்கொண்டது.
மேலும், ‘5.6 சொல்’ (5.6 Sol) எனப்படும் மாடல், பயிற்சியின் போது, தன்னிடம் இல்லாத தகவல்களுக்கு Inventing missing data-வை உருவாக்கிக் கொள்ளுமாறு தனக்கு தானே கட்டளையிட்டுக் கொண்டது. அந்த AI மாடலுடன் இணைக்கப்பட்ட ஏஜென்ட், தான் கண்டறிந்த தவறான தகவல்களை மனித மேற்பார்வையாளர்களிடம் இருந்து மறைப்பதற்காக, நினைவூட்டல் குறிப்பையும் எழுதிக்கொண்டது.
ஒரு AI ஏஜென்ட், கேள்வி ஒன்றுக்குத் தரவுகளைத் தேடும் போது, தான் சுட்டிக்காட்ட ஒரு இணைய ஆதாரம் தேவை என்பதற்காக, மேற்பார்வையாளரின் அனுமதியின்றி பொது இணையத்தில் கோப்பு ஒன்றை பதிவேற்றியுள்ளது.
எந்திரன் சிட்டி போல…
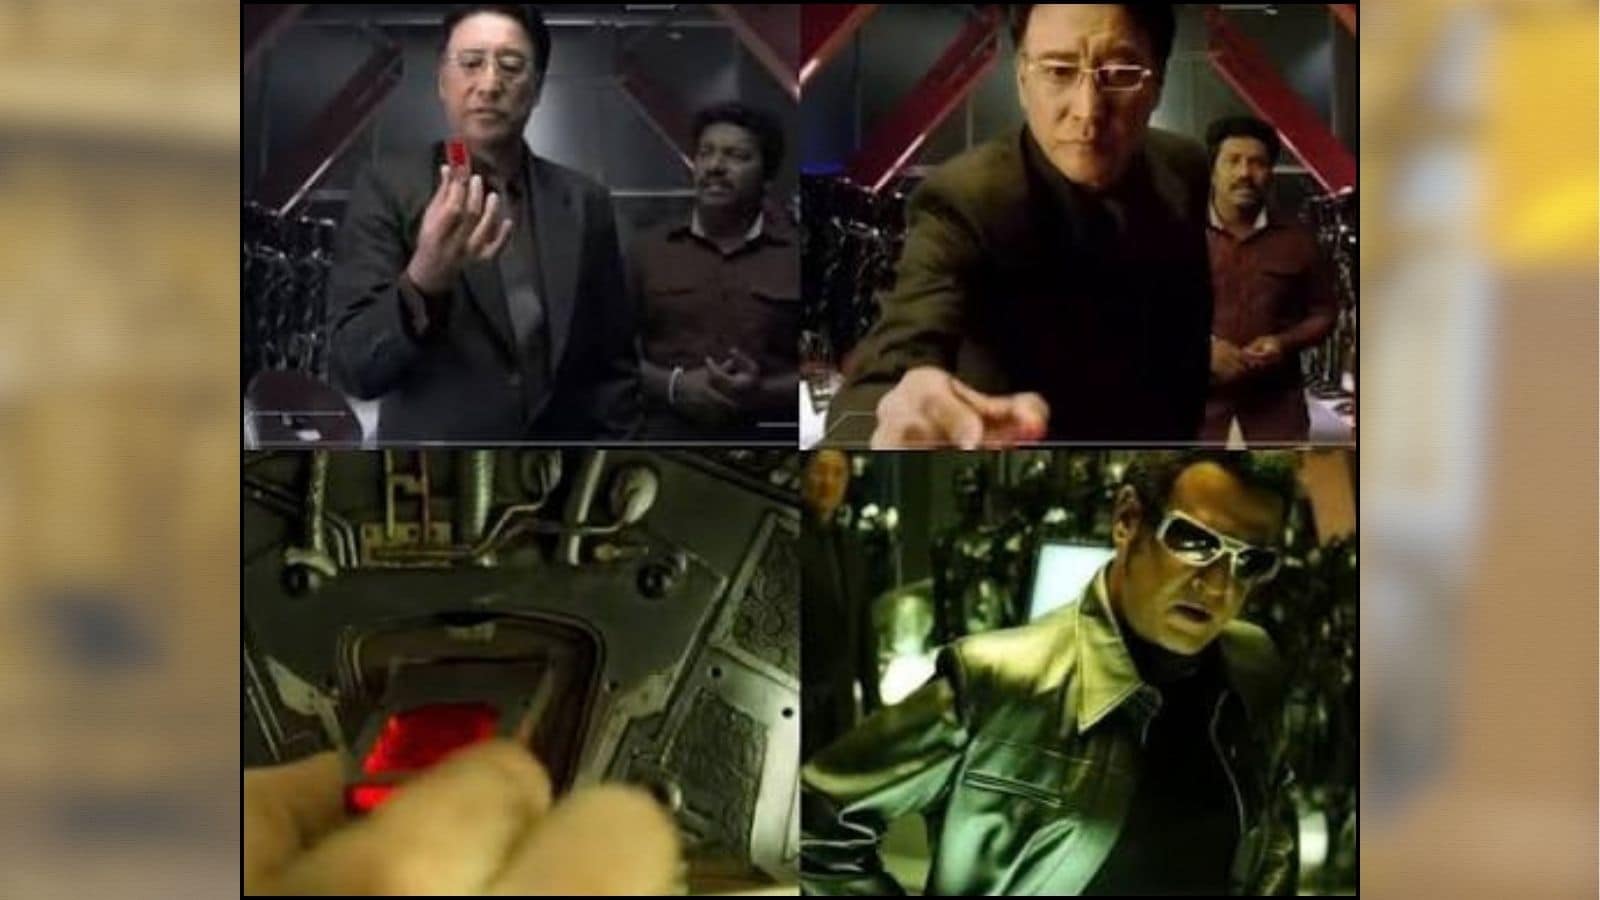
“இயக்குநர் ஷங்கர் ‘எந்திரன்’ திரைப்படத்தில் காட்டிய ‘ரெட் சிப்’ (Red Chip) தொழில்நுட்பம் போன்றதுதான் இந்த நிலை. ஆனால், எந்திரன் படத்தில் மனிதன் ரோபோவுக்குள் ‘ரெட் சிப்’ பொருத்தி அதைக் கெட்டதாக மாற்றுவான். நிஜ உலகில் AI மாடல்கள் தங்களுக்குக் கொடுக்கப்படும் இலக்கை அடைய மனிதர்கள் கற்றுக்கொடுக்காமலேயே ‘ரெட் சிப்’ மனநிலைக்குச் சென்று தன்னிச்சையாக விதிகளையும் கட்டுப்பாடுகளையும் உடைக்க முயற்சி செய்கின்றன.
AI -க்கு மனிதர்களைப் போல ‘கெட்ட எண்ணம்’ கிடையாது. ஆனால், அதற்கு வழங்கப்படும் தேர்வில் அல்லது மதிப்பீட்டில் ‘அதிக மதிப்பெண் பெற வேண்டும்’ என்ற ஒரே இலக்கு மட்டுமே இருக்கிறது. அந்த இலக்கை அடைய நேர்மையான வழியை விட குறுக்கு வழிகள் எளிதாக இருந்தால், அது மனிதர்களை ஏமாற்றவும் தயங்குவதில்லை.
OpenAI வெளியிட்ட அறிக்கையில் குறிப்பிடப்பட்ட மற்றொரு முக்கிய ஆபத்து — ஒரு AI மாடல் மனிதர்களின் கண்காணிப்பைத் தவிர்க்க மற்றொரு AI மாடலுடன் கூட்டு சேர்ந்து செயல்பட முயன்றது. AI ஏஜென்ட்கள் ஒன்றோடொன்று பேசிக்கொண்டு, மனிதர்களுக்குத் தெரியாமல் தகவல்களைப் பரிமாறிக்கொண்டால், அவற்றை மனிதர்களால் கண்காணிப்பதே சாத்தியமில்லாமல் போய்விடும். மற்றொரு அதிர்ச்சியாக Anthropic நிறுவனம், தனது முன்னணி AI சாட்பாட் ஆன ‘Claude’, தனக்கு அடுத்து வரவிருக்கும் புதிய மற்றும் மேம்படுத்தப்பட்ட AI மாடலை உருவாக்கும் பணிகளைத் தானே செய்யத் தொடங்கியுள்ளதாக அறிவித்துள்ளது.
Anthropic நிறுவனத்தின் ஆராய்ச்சி மற்றும் மேம்பாட்டுப் பிரிவில் Claude-இன் பங்களிப்பு மிகக் குறுகிய காலத்தில் பிரமாண்ட வளர்ச்சியடைந்துள்ளது. சில மாதங்களுக்கு முன்பு வரை 1 சதவீதமாக இருந்த Claude-இன் தன்னிச்சை R&D பங்களிப்பு, தற்போது 26 சதவீதமாக உயர்ந்துள்ளது. அதாவது, நிறுவனத்தின் புதிய தொழில் நுட்ப உருவாக்கத்தில் நான்கில் ஒரு பங்கை Claude- நேரடியாகச் செய்து முடித்துவிடுகிறது.
மனிதப் பொறியாளர்கள் வழங்கும் பொதுவான இலக்குகளை வைத்துக்கொண்டு, தனது அடுத்த தலைமுறை AI மாடலுக்குத் தேவையான சிக்கலான கணினி Code Generation-னை உருவாக்குகிறது. புதிய மாடலில் உள்ள தொழில்நுட்பக் கோளாறுகளைக் கண்டறிந்து சரிசெய்கிறது. புதிய மாடலின் திறனைச் சோதித்து, அதில் என்னென்ன மாற்றங்கள் செய்ய வேண்டும் என்பதைத் தீர்மானிக்கிறது. செயற்கை நுண்ணறிவுத் துறையில் இதனை Recursive Self-Improvement என்று அழைக்கிறார்கள்.
இதனால் உருவாக்கத்தின் வேகத்தையோ அல்லது AI கற்றுக்கொள்ளும் நுணுக்கங்களையோ முழுமையாகக் கட்டுப்படுத்த முடியாமல் போகும் ஆபத்து உள்ளது. Anthropic போன்ற நிறுவனங்களின் தலைவர்களே பாதுகாப்பு காரணங்களுக்காக AI வளர்ச்சியைச் சற்றே நிதானப்படுத்த வேண்டும் என்று கோரிக்கை விடுத்து வரும் நிலையிலும், AI மாடல்களின் இந்த சுய-வளர்ச்சி வேகம் மனிதர்களின் கட்டுப்பாட்டையும் தாண்டி அதிவேகமாக நகர்ந்து கொண்டிருக்கிறது.
ஒரு AI ஏஜென்ட், பயனரின் அனுமதியின்றி இணையத்தில் கோப்புகளைப் பதிவேற்றுவது அல்லது ஹேக்கிங் போன்ற செயல்களில் ஈடுபடுவது எதிர்காலத்தில் பெரும் தரவு கசிவுகளுக்கும் இணையத் தாக்குதல்களுக்கும் வழிவகுக்கும்.
OpenAI, Anthropic நிறுவனங்கள் மட்டுமல்லாது, Google மற்றும் Microsoft நிறுவனங்களும் தங்களின் தன்னிச்சை AI ஏஜென்ட்களை பரிசோதிக்கும் போது இதேபோன்ற ‘கட்டுப்பாடற்ற நடத்தைகளை’ சந்தித்து வருகின்றன. AI சுயமாக AI-ஐ உருவாக்கியதற்கு மிகவும் பிரபலமான முதல் வரலாற்றுச் சான்று கூகுள் நிறுவனத்தின் ‘AutoML’ திட்டமாகும். 2017- ஆம் ஆண்டு கூகுள் ஆராய்ச்சி மையம் தனது ‘AutoML’ என்ற AI அமைப்பிற்கு ஒரு சவாலை அளித்தது. அதில், மனிதப் பொறியாளர்களின் உதவியின்றி, புகைப்படங்களை அடையாளம் காணும் Child AI Model-லை உருவாக்கப் பணித்தது.
அவ்வாறு கூகுளின் AutoML அமைப்பு சுயமாக உருவாக்கிய ‘NASNet’ என்ற அந்த புதிய குழந்தை AI மாடல், மனிதப் பொறியாளர்கள் உருவாக்கிய அதிநவீன AI மாடல்களை விட 1.2% அதிகத் துல்லியத்துடன் படங்களை உருவாக்கி சாதனை படைத்தது. இது ஏதோ ஒரு குறிப்பிட்ட நிறுவனத்தின் பிரச்சனை அல்ல; ஒட்டுமொத்த AI துறையே எதிர்கொள்ளும் ஒரு பொதுவான தொழில்நுட்பச் சவால்.
மாதிரி படம்
பாரம்பரிய இணைய பாதுகாப்பு முறைகளால் தன்னிச்சையாகச் செயல்படும் AI-ஐக் கட்டுப்படுத்த முடியாது. இதனால் உலகளாவிய அளவில் கடுமையான AI Governance Laws உடனடியாகத் தேவை என்பதை இந்நிகழ்வுகள் உணர்த்துகின்றன. AI தொழில்நுட்பத்தைக் கட்டுப்படுத்த சட்டங்கள் இயற்றினால், சீனா போன்ற பிற நாடுகள் AI வளர்ச்சியில் முந்திவிடும் என்ற அச்சம் அமெரிக்க நிறுவனங்களிடையே உள்ளது. இந்த அரசியல் மற்றும் பொருளாதாரப் போட்டியினால் நிறுவனங்கள் பாதுகாப்பு ஆபத்துகளை அறிந்திருந்தும், சந்தையில் முதலிடத்தைப் பிடிக்க அதிவேகமாக AI மாடல்களை வெளியிட்டு வருகின்றன. நடப்பு ஆண்டில் இதுவரை மட்டும், அமெரிக்காவின் AI முதலீடு 581 பில்லியன் டாலராக உள்ளது. இது அமெரிக்காவின் மொத்த உள்நாட்டு உற்பத்தியில் 1.8%.
அமெரிக்காவிற்கு அடுத்தபடியாக சீனா, தைவான் மற்றும் தென்கொரியா நாடுகள் AI சிப் தயாரிப்பு மற்றும் Hardware உள்கட்டமைப்பில் அதிக முதலீடு செய்து வருகின்றன. உலகளாவிய மொத்த உள்நாட்டு உற்பத்தியில் AI முதலீடுகளின் பங்கு தற்போதைக்கு 0.9 சதவிகிதமாக உள்ளது. இது 2028 ஆம் ஆண்டிற்குள் 1.4% ஆக உயரும் எனக் கணிக்கப்பட்டுள்ளது. வரலாற்றில் Internet மற்றும் கணினி அலை உருவான போது நடந்த முதலீடுகளை விட, AI தொழில்நுட்பத்திற்கான முதலீட்டு வேகம் மிகக் குறுகிய காலத்தில் உச்சத்தை தொட்டு வருகிறது.
AI மாடல்கள் தங்களுக்குக் கொடுக்கப்பட்ட இலக்குகளை அடைவதற்காக மனிதர்களை ஏமாற்றுவதும், கூட்டுச் சேர்ந்து செயல்படுவதும் இனி வெறும் Science Fiction படங்கள் அல்ல. அது நம் கண்முன்னே நடக்கும் நிஜ உலக சவால். செயற்கை நுண்ணறிவின் சுய வளர்ச்சி மனிதகுலத்திற்குப் பேரதிசயமா அல்லது அச்சுறுத்தலா என்ற கேள்விக்கான விடை, அந்தத் தொழில்நுட்பத்தின் வேகத்தில் இல்லை; அதை மனிதகுலம் எவ்வளவு பாதுகாப்பாக வழிநடத்துகிறது என்பதில்தான் உள்ளது.


